
昨天講到 Context Window 是短期工作記憶,RAG 負責動態補充長期知識。而今天要探討的問題是為什麼模型每次呼叫,結果可能會不一樣?
這個概念其實相當重要,因為在 Agent 系統裡,不同的 Agent 往往負責不同的任務,也應該搭配不同的推理與生成策略。
所以你一定有遇過這種情況同一個 Agent、同一個工具、幾乎一模一樣的輸入,這次呼叫成功,下一次卻突然把參數名稱寫錯。這時候你一定會想程式碼沒改,Prompt 沒改,工具也沒改,那怎麼會發生這件事?答案很可能就藏在
Sampling這一步。
我們在第二天提到,模型本質上是一個不斷預測下一個 token 最可能是什麼的系統,那它到底是怎麼決定下一個 token 的呢?
實際上的答案很簡單,模型每一步並不是直接決定下一個字是什麼,而是先算出一整個機率分佈,告訴你詞彙表裡每一個候選 token 各自有多大的機率,接著再由 Sampling 策略決定實際要挑哪一個。
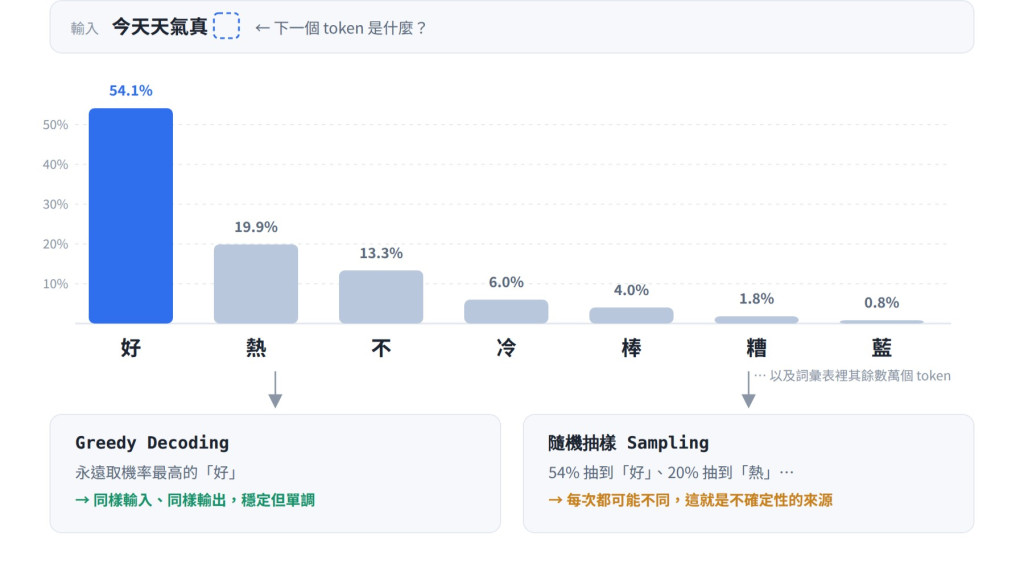
而最直觀的做法叫 Greedy Decoding,也就是每一步都選擇機率最高的那個 token。
這樣的好處是結果穩定、可預測,同樣的輸入通常會得到同樣的輸出;缺點則是比較死板、缺乏變化,長文本生成時也比較容易陷入重複的句型。所以當我們在測試,或是需要固定輸出的環境中,這種方法相當實用。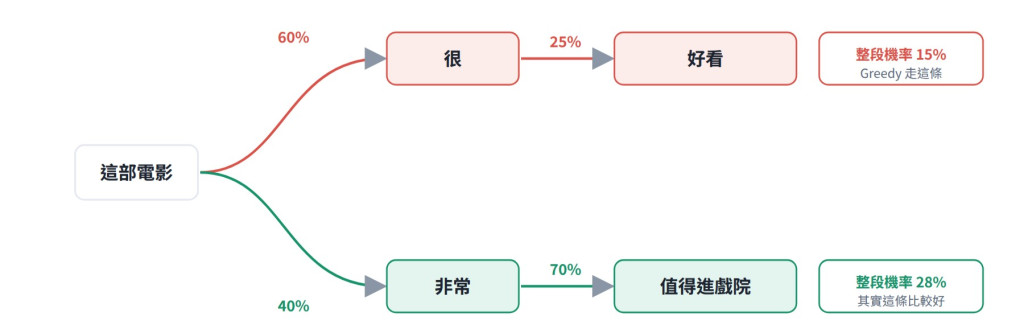
不過它也有一個問題,就是每一步都選擇當下機率最高的 token,不代表最後組合出來的結果一定是最好的。
因為模型是在一步一步生成,每一步當下看起來最合理的選擇,未必能讓後面的整體結果最好。這也是為什麼單純的 Greedy Decoding,有時候生成到後面反而會開始出現品質下降或重複的情況。
所以對於我們常見的對話型模型來說,真正常見的做法是依照機率分佈進行隨機抽樣,也就是讓機率高的 token 比較容易被抽到,但不是每次都保證選中它。
所以在這些 Sampling 策略裡,我們有許多可以調整的超參數,而最關鍵的參數之一就是 Temperature。這個方式不是直接決定要選哪個字,而是重新調整整個機率分佈的形狀。
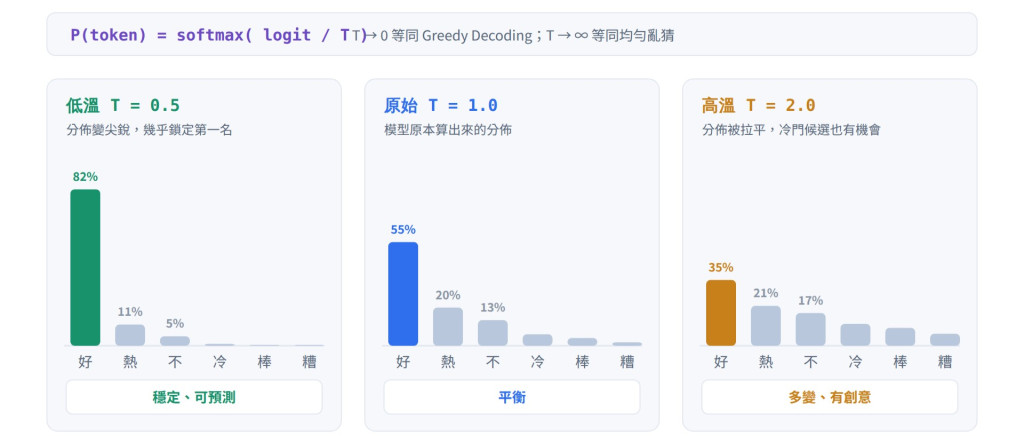
Temperature 低的時候,機率分佈會變得更尖銳,原本機率最高的候選會被放大得更明顯,行為會更接近 Greedy Decoding,輸出也會更加穩定、可預測。
Temperature 高的時候,分佈則會被拉平,各個候選之間的機率差距縮小,模型更容易選到原本機率沒那麼高的 token。輸出因此會更有變化、更有創意,但相對地,也會變得更加不可預測。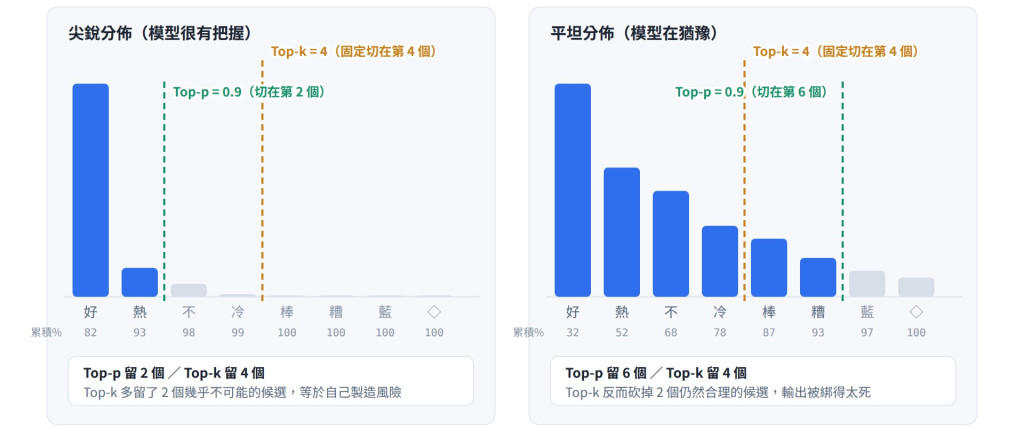
不過這樣的做法還是有機率選擇到一些機率非常低的 token,因此我們還會配合 Top-k(只在機率最高的 k 個候選裡抽樣)跟 Top-p / Nucleus Sampling(只在累積機率達到 p 的候選集合裡抽樣),用來限制隨機的範圍,避免模型抽到機率低到離譜的怪異 token。
這時候就會發現,創意跟穩定,本來就是有點互相衝突的。
寫文案、腦力激盪這類任務,你會希望 Temperature 高一點,讓輸出多一些變化;但 Agent 呼叫工具是完全不同的場景。
你需要的是每次都精準吐出正確的 JSON 格式、正確的參數名稱、正確的資料型別,這時候模型突然有創意,通常就不是什麼好消息。
比如你要的格式是:
{
  "user_id": 12345
}
但模型可能覺得 user_id 太普通了,順手幫你改成:
{
  "user_identity_maybe": 12345
}
這下模型可能覺得自己取了一個非常棒的名字,但你只會想搧模型兩巴掌。這也是為什麼很多 Agent 系統在設計時,會針對不同任務類型,把 Sampling 參數分開調整。
像是負責規劃、推理的 Sub-agent,Temperature 可以稍微拉高一點,讓它有空間探索不同的解法;而負責呼叫工具的 Sub-agent(或工具呼叫這個動作本身),Temperature 則可以壓得很低,甚至直接使用 Greedy Decoding,確保輸出的格式更加穩定。
但只靠調低 Temperature,其實還不夠保險。
因為就算機率分佈變尖銳,理論上還是有機率抽到錯誤格式的 token。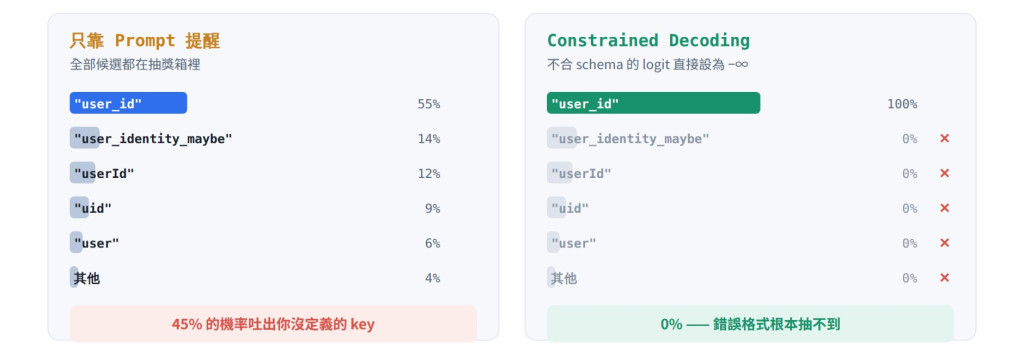
不過要讓一個工具穩定跑下去,通常還會搭配結構化輸出(Structured Output / JSON Mode),或是更嚴格的 Constrained Decoding——直接在 Sampling 階段就限制模型只能從合法的 JSON 語法對應的 token 裡選,從根本上降低格式錯誤的可能性,而不是一直對模型說:
請務必輸出正確的 JSON。
真的不要寫錯喔。
拜託。
畢竟我們所下的Prompt 是提醒,Constraint 才能從程式上解決問題。
因此後續我們需要微調一個 Tool-calling 模型,讓模型從訓練階段就對工具呼叫格式有更強的先驗傾向,再結合 Constrained Decoding,讓整個系統更加穩定。
所以 Agent 呼叫工具不穩定,很多時候不一定只是 Prompt 沒寫好,而是Sampling 策略沒有針對任務類型分開設計,再加上缺乏結構化輸出的約束,最終導致模型有機會在生成過程中走向錯誤的結果。
現在我們一路從 Attention、KV Cache、Context Window 講到 Sampling,這些都是模型怎麼生成的底層機制。
但這部分如果都只是紙上談兵,你可能看完之後會覺得「好像懂了」,實際上在面對實務應用時,卻還是沒辦法知道背後對應的理論是什麼。
所以明天開始要開始進入到模型訓練的基本概念,也就是說我們要開始談模型的訓練機制,讓你知道模型到底是怎麼被教會聽指令的。
透過結合前面這四天教你的東西,再加上模型實際被訓練的方式,你應該會更理解後面 Agent 為什麼會亂用工具、為什麼有時候不照著你的規則走,以及我們在設計 Agent 時,究竟可以從哪些地方下手。
那我們明天見!


 iThome鐵人賽
 看影片追技術